Esta página explica a mecânica do experimento: como escolas de rede pública viram observações, como as observações viram duas representações de série, como cinco métodos rodam sobre elas, e como o resultado disso vira uma decisão sobre quantos livros comprar. Não substitui o guia de execução (parâmetros e ordem dos experimentos) nem o plano de experimentos (a especificação da rodada de Maceió) — os dois continuam sendo a referência normativa. Aqui o objetivo é outro: mostrar por que cada peça existe, com o menor jargão possível.
2 (pré-escola) → 27 (3ª EM)
pré→1ºEF · 5º→6ºEF · 9ºEF→1ºEM
m10 a m70, mais m40b (ARIMA)
fiel à defasagem real do PNLD
1. A taxonomia: duas perguntas sobre a mesma série
Toda série de matrícula neste trabalho responde a duas perguntas independentes. A primeira é de onde vem o histórico que alimenta a predição: da própria etapa-alvo, ano a ano (retroativa), ou da trajetória que a coorte deveria ter percorrido para chegar até ali, encadeando etapas anteriores (escalonada). A segunda é onde a etapa-alvo está na cadeia: internamente, sem mudança estrutural esperada na origem do aluno, ou numa fronteira — o destino de uma das três transições em que o aluno tipicamente troca de escola, de rede ou de segmento.
As duas classificações vêm de lugares diferentes do código. Retroativa/escalonada é uma
propriedade da série — pipeline/m30_series.py gera as duas para cada
(escola, etapa-alvo, ano-alvo). Interna/fronteira é uma propriedade da etapa-alvo —
calculada uma vez em pipeline/m10_ingestao.py::construir_mapa_transicoes e herdada por
toda predição daquela etapa, nunca recalculada por escola.
| Retroativa | Escalonada |
|---|---|
| Etapa-alvo fixa; observa a mesma etapa, na mesma escola, em anos anteriores. | Observa a etapa anterior na cadeia a cada ano de defasagem — uma etapa diferente por ano, a trajetória que a própria coorte percorreu. |
| Elegível onde a escola já ofertou a etapa-alvo antes, pelos anos que bastarem. | Inelegível por construção onde a cadeia não tem passos suficientes antes do alvo — não é falta de dado (ver exemplo abaixo). |
As 13 etapas e sua classificação
| Código | Etapa | Papel na cadeia | Classificação do alvo |
|---|---|---|---|
| 2 | Pré-escola | origem — só entra como histórico | nunca é etapa-alvo |
| 14 | 1º EF | alvo | fronteira recebe Pré → 1º EF |
| 15 | 2º EF | alvo | interna |
| 16 | 3º EF | alvo | interna |
| 17 | 4º EF | alvo | interna |
| 18 | 5º EF | alvo | interna |
| 19 | 6º EF | alvo | fronteira recebe 5º → 6º EF |
| 20 | 7º EF | alvo | interna |
| 21 | 8º EF | alvo | interna |
| 41 | 9º EF | alvo | interna — não confundir com 22 |
| 25 | 1ª EM | alvo | fronteira recebe 9º EF → 1ª EM |
| 26 | 2ª EM | alvo | interna |
| 27 | 3ª EM | alvo | interna |
Fonte: pipeline/config.py (ETAPA_NOME,
TRANSICOES_CRITICAS) e config.yaml (cadeia_progressao,
escopo.etapas_alvo). Classificação interna/fronteira calculada em
pipeline/m10_ingestao.py::construir_mapa_transicoes.
O código de etapa do INEP para o 9º ano do Fundamental é 41. O código
22 existe no Censo, mas é "EF Multi" — uma etapa residual, fora do escopo de
educação básica regular deste trabalho (não listada em config.yaml: escopo.etapas_alvo).
Confundir os dois quebra silenciosamente a cadeia entre o 8º EF e a 1ª EM. Por isso
pipeline/m10_ingestao.py registra em relatorio_e0.md se o código 22
aparece nos dados de origem — um sanity check pensado justamente para pegar esse erro antes que
ele se propague pelo resto do pipeline.
Exemplo: de onde cada representação puxa o histórico
O site publica só dados agregados — nenhuma predição ou série é atribuída a uma escola
identificável. O gráfico abaixo usa uma escola fictícia, com matrículas geradas
por fórmula (não é um caso real). O que não é fictício é a mecânica: os pontos
que aparecem em cada alvo são exatamente o que
pipeline/m30_series.py::construir_series_retroativa/escalonada produz para essa
tabela — mesma cadeia de progressão e mesmo gap T−2 de config.yaml, código de
produção sem alteração (gerador: tools/figuras_como_funciona.py).
Como ler. escolha um alvo nos botões acima do gráfico. Pontos azuis (retroativa) sempre reaparecem na mesma etapa, em anos diferentes; pontos vermelhos (escalonada) são uma etapa diferente a cada ano — a trajetória que a coorte deveria ter percorrido. A faixa vermelha à direita é o gap T−2: nenhum ano ali entra no treino.
| Alvo | Transição | Anos de histórico — retroativa | Defasagens possíveis — escalonada | Etapas que a escalonada alcança |
|---|---|---|---|---|
| 1º EF (14) | Pré → 1º EF | 15 | 0 | nenhuma — inelegível por construção |
| 6º EF (19) | 5º → 6º EF | 15 | 5 | 4º, 3º, 2º, 1º EF e Pré-escola — pula o 5º EF |
| 1ª EM (25) | 9º EF → 1ª EM | 15 | 9 | 8º ao 1º EF e Pré-escola — pula o 9º EF |
Contagens do exemplo ilustrativo acima (histórico contínuo 2007–2023, sem falha de oferta — o caso mais favorável possível à escalonada). Numa escola real, com séries incompletas, os números de defasagem tendem a ser menores, nunca maiores.
k, a defasagem em anos, começa em protocolo.gap_minimo (2), não em 1 —
a mesma regra antivazamento que limita a retroativa. Como cada ano de defasagem também é um passo
na cadeia, a etapa mais recente que a escalonada consegue observar já é a segunda
anterior ao alvo, nunca a primeira. É uma consequência direta e simétrica do gap T−2 — a mesma
regra vale para as duas representações, não é uma limitação isolada da escalonada.
2. Como um experimento acontece: m10 → m70
Um run do pipeline é sete módulos numerados (mais um oitavo, opcional, para o ARIMA), cada um
lendo config.yaml e nada mais, cada um gravando um artefato nomeado que o próximo
módulo lê. Nenhum parâmetro é lido de fora do config; nenhum módulo reexecuta o que o anterior já
fez.
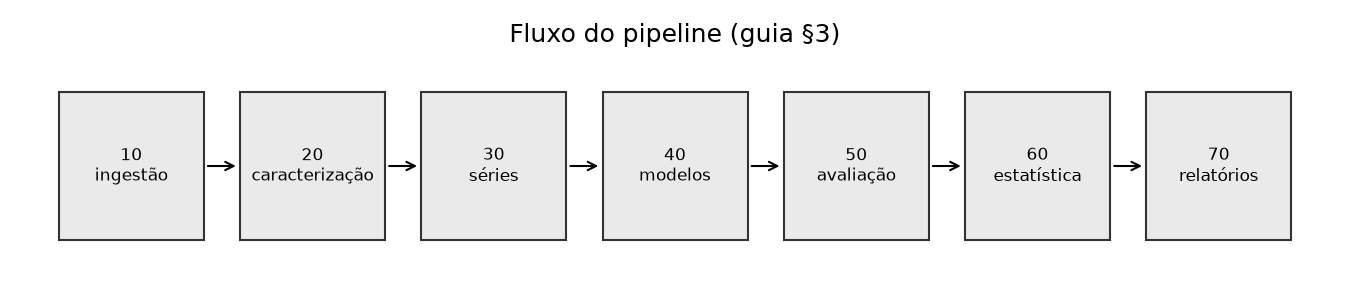
Como ler. os sete módulos numéricos, em ordem — a mesma figura que
pipeline/m70_relatorios.py::_fig_fluxograma gera para o relatório de cada run
(reaproveitada aqui, não redesenhada). O guia de
execução §2 detalha os artefatos A–F que cada módulo produz; abaixo, o que cada módulo faz e
por quê, direto da docstring de cada arquivo.
Extraídas no build, sem Sphinx — "documentação de código barata", como o autor pediu:
build.py::docstrings_pipeline_html lê a árvore sintática de cada
pipeline/m*.py com ast.parse — sem importar o módulo, sem puxar pandas
ou numpy só para gerar o site — e renderiza a docstring de módulo tal como está no código. Clique
para abrir cada uma:
m10_ingestao.py — Módulo 10 — Ingestão (guia §3.1, plano Fase 1)
Entrada:
- dados.matriculas_raw (config.yaml) — brasil_2007_2025.csv, grão escola x etapa x ano (nu_ano_censo, sg_uf, co_municipio, co_entidade, co_tp_localizacao, co_etapa_ensino, qtd_alunos). Fonte única para matrícula; NÃO usar os CSVs brutos anuais do INEP (não têm granularidade por etapa — só totais por bloco AI/AF/EM).
- dados.escola_dependencia — snapshot único 2025 (decisão E0 registrada: dependência por ano é inviável, ver config.yaml e relatório de E0).
- escopo.etapas_alvo / escopo.etapa_origem_extra (config.yaml) — restringe à educação básica regular (infantil, fundamental completo, médio completo); exclui EJA, técnico/FIC, normal/magistério, não seriado.
Saída:
- data/canonico/observacoes.parquet (arquivo A do guia §2): join de dependência, filtro rede pública {1,2,3}, filtro de escopo de etapas.
- data/mapa_transicoes_etapas.csv (arquivo B): cadeia de progressão copiada de cadeia_progressao (config.yaml) — armadilha: 9º ano é a etapa 41, não 22.
- runs/<run_id>/relatorio_e0.md: sanity checks (E0, guia §8) + entrada correspondente em registry/registry_experimentos.yml.
Testes (tests/test_m10_ingestao.py): schema de A, unicidade escola-etapa-ano, cadeia de B sem o código 22.
Fonte: pipeline/m10_ingestao.py, docstring de módulo (extraída no build, sem Sphinx).
m20_caracterizacao.py — Módulo 20 — Caracterização e persistência (guia §3.2, plano Fase 2, experimento E5)
Entrada: data/canonico/observacoes.parquet (A) + data/mapa_transicoes_etapas.csv (B).
Saída: descritivas da base — estabilidade ano-a-ano por etapa/posição, persistência de oferta de etapas por escola, distribuição de tamanho de série. Alimenta a investigação de por que "repetir o último valor" é um baseline forte (SP3, exigência da banca — CONTEXTO.md §15.2/§15.3) e a Tabela T1 do guia §9.
A comparação ano-a-ano exclui deliberadamente o par (2017, 2018): E0 (runs/e0-20260729-112118/relatorio_e0.md) documentou um salto de 3,22x na granularidade da base bruta entre esses dois anos, não uma mudança real de matrícula — incluí-lo contaminaria a leitura de estabilidade com um artefato da base, não um sinal real.
Fonte: pipeline/m20_caracterizacao.py, docstring de módulo (extraída no build, sem Sphinx).
m30_series.py — Módulo 30 — Séries: retroativa e escalonada (guia §3.3/§4, plano Fase 3/4)
Entrada: data/canonico/observacoes.parquet (A).
Saída: data/canonico/series_modelagem.parquet (arquivo C) — formato longo (serie_id, representacao, co_entidade, etapa_alvo, ano_alvo, lag_k, ano_obs, etapa_obs, valor, n_hist, elegivel), com duas representações:
- retroativa: etapa_obs == etapa_alvo, mesma escola, anos anteriores.
- escalonada: para o alvo
eno anoy, usa a etapa anterior na cadeia em y-k (mesma escola) — a trajetória esperada da coorte.kcomeça em protocolo.gap_minimo (não em 1), para respeitar o mesmo gap T-2 da retroativa. Como a cadeia (config.yaml: cadeia_progressao) já liga pré-escola -> ... -> EF -> EM inteira, um alvo de Ensino Médio encadeia sozinho até o Fundamental — satisfaz a reconstrução pedida em E-EM (guia §8) sem código especial.
serie_id é hash md5 determinístico de (co_entidade, etapa_alvo, ano_alvo, representacao) — estável entre runs, calculado uma vez por série (não por linha) para não pagar hash em cada observação histórica.
Regras (guia §4/§6), válidas para as duas representações:
etapa_alvorestrito a escopo.etapas_alvo (pré-escola é só origem, nunca etapa-alvo).- Anos-alvo = protocolo.anos_alvo_backtest (backtesting de origem móvel).
- Zeros são ausência de oferta, não quantidade — descartados do histórico antes de contar
n_hist(não geram linha em C). elegivel= n_hist >= elegibilidade.min_anos_treino.
Cobertura estrutural da escalonada: etapas logo após a pré-escola (14, 15, 16, 17) têm, no máximo, 0 a 3 lags possíveis dentro da cadeia com gap T-2 — sempre abaixo do mínimo de 4 anos, portanto **inelegíveis por construção**, não por falta de dados. É um achado (mesma natureza da cobertura baixa do 1º EM esperada em E-EM), não um bug — ver relatório de E2/E4.
Elegibilidade não implica alvo observável: a escalonada gera uma linha em C sempre que a *cadeia de origem* existe (mesma escola, etapas/anos anteriores), independentemente de a escola ofertar a etapa_alvo no ano_alvo — elegivel só depende de n_hist sobre o histórico, nunca do valor em ano_alvo. Por isso n_elegivel (histórico suficiente) e n_avaliavel (elegível + y_true não-nulo no ano_alvo, calculado a partir de observacoes.parquet em m40_modelos) divergem muito mais na escalonada do que na retroativa — a escalonada fica "elegível" para etapas que a escola já não oferta mais (ex.: EF completo sem 1ª série de EM), enquanto a retroativa só é elegível para etapas que a própria escola já ofertou nos mesmos anos usados como histórico. As métricas em si nunca ficam contaminadas por isso (m50_avaliacao.avaliar filtra y_true.notna()); o que precisa ser lido com cuidado é a tabela de cobertura, que deve reportar as duas contagens separadamente (ver cobertura_por_representacao).
Teste antivazamento obrigatório (guia §6): max(ano_obs) <= ano_alvo - 2 em C.
Fonte: pipeline/m30_series.py, docstring de módulo (extraída no build, sem Sphinx).
m40_modelos.py — Módulo 40 — Modelos (guia §3.4/§5, plano Fase 3)
Entrada: data/canonico/series_modelagem.parquet (C, representação retroativa).
Saída: runs/<run_id>/predicoes.parquet (arquivo D, append-only por run) — os 5 métodos P0 (média, último valor, regressão linear, suavização exponencial, Kalman) sobre séries elegíveis (n_hist >= min_anos_treino).
Vetorização (guia §3): média, último valor e regressão linear são calculados via agregação pandas (groupby + forma fechada de mínimos quadrados para reglin) — sem laço Python por série. Suavização exponencial e Kalman são recursivos por natureza e rodam em um único laço por série (o "caso série-a-série" citado no guia); os dois juntos, para não pagar o overhead de agrupamento duas vezes.
Fallback (guia §4): séries com histórico parcial (1 a min_anos_treino-1 anos) só recebem "último valor" (fallback_usado=True); análises comparativas devem usar o subconjunto sem fallback (fallback_usado == False).
elegivel é recomputado aqui a partir de n_hist e de config["elegibilidade"]["min_anos_treino"] — nunca lido da coluna elegivel gravada por m30_series.py. m30 grava todas as séries com n_hist já contado e só marca elegivel com o min_anos_treino do config.yaml vigente no momento em que rodou; se este módulo confiasse nessa flag, rodar um run de sensibilidade de min_anos_treino (ex.: config_min2) exigiria re-rodar o m30 inteiro (caro: ~808 MB, a etapa mais pesada do pipeline) só para trocar um limiar. Como C já carrega n_hist por série, recomputar elegivel = n_hist >= min_anos_treino aqui é O(1) por série e respeita a disciplina do projeto ("config é a única fonte") — qualquer outro módulo que precisar de elegibilidade deve fazer o mesmo, nunca confiar em uma flag congelada por outro módulo em outro momento.
y_true vem diretamente de observacoes.parquet no ano_alvo — pode ser nulo se a escola não ofertou a etapa naquele ano (a predição ainda é escrita, mas erro/erro_abs ficam nulos e m50_avaliacao descarta essas linhas).
Fonte: pipeline/m40_modelos.py, docstring de módulo (extraída no build, sem Sphinx).
m40b_arima.py — Módulo 40b — ARIMA (item 2 da auditoria), extensão de m40_modelos
Não substitui m40_modelos.py nem seu predicoes.parquet: escreve um arquivo irmão, runs/<run_id>/predicoes_arima.parquet, com **exatamente o mesmo schema** de D (pipeline.m40_modelos.COLUNAS_D, metodo="arima"). m50 e m60 concatenam todos os predicoes*.parquet do diretório do run, então o ARIMA entra nas tabelas e testes do pipeline sem reescrever o arquivo grande já publicado e sem perder rastreabilidade (guia: "config é a única fonte", aplicado aqui a "run é a única fonte" — nunca sobrescrever D).
Mudança de escopo (registrada aqui, não só em pipeline/modelos/arima.py, porque muda a arquitetura deste módulo): a primeira versão rodava statsmodels série a série (Python puro), tinha que amostrar porque não cabia em ~2h. A versão atual ajusta IMA(1,1) sem constante por soma de quadrados condicional (CSS) **vetorizada em numpy sobre todas as séries de uma vez** (pipeline.modelos.arima.ajustar_lote) — não há mais laço Python por série no caminho de produção, então a amostragem estratificada saiu: este módulo roda a base elegível inteira do run canônico. Só o run canônico (e1-20260729-122616) roda ARIMA por enquanto — decisão do autor; o run min=2 fica para depois, o código já suporta (basta apontar --run-id/--config), só não foi executado ainda.
Entrada: data/canonico/series_modelagem.parquet (C) + observacoes.parquet (A, para y_true) — os mesmos arquivos de m40_modelos.py. elegivel é recomputado a partir de n_hist e config["elegibilidade"]["min_anos_treino"], pela mesma razão e do mesmo jeito que em m40_modelos.gerar_predicoes.
Construção da matriz (construir_matriz): filtra C para linhas elegíveis (vetorizado — n_hist já está em cada linha de C, não precisa de groupby para decidir elegibilidade), ordena por (serie_id, ano_obs), calcula a posição de cada observação dentro da série (groupby.cumcount) e a primeira diferença (groupby.diff), e espalha os dois numa matriz densa (n_series, T) via indexação numpy — sem laço Python por série. T = maior n_hist-1 da base (<=16, já que o maior n_hist observado é 17). Para o run canônico isso é uma matriz de ~4,8M x 16 (~614 MB em float64) — cabe folgado nos 19 GB de RAM da máquina.
Processamento em blocos (modelos.arima.execucao.tamanho_bloco_series, config.yaml): pipeline.modelos.arima.ajustar_lote nunca materializa uma matriz grade × N (mantém só o melhor (soma_quadrados, theta) corrente por série), então o pico de memória por chamada é O(N), não O(grade × N) — a matriz densa acima já é o maior consumidor. Ainda assim, processar em blocos de séries é a margem de segurança pedida: cada bloco aloca só O(tamanho_bloco) nos arrays intermediários da varredura de θ, em vez de O(n_series inteiro), o que importa se a base crescer além do run canônico atual.
ARIMA só é ajustado sobre séries elegíveis (mesmo critério de suav_exp e kalman em m40_modelos) e com histórico suficiente para identificar θ (n_hist >= 3 — ver docstring de pipeline/modelos/arima.py); no run canônico (min_anos_treino=4) toda série elegível já satisfaz isso, então não há filtro adicional. Séries onde o ajuste falha (não deveria acontecer para n_hist>=3, mas a função pode devolver NaN em casos degenerados) recebem sucesso=False, motivo_falha="arima_historico_insuficiente".
Além de predicoes_arima.parquet (schema D), este módulo grava runs/<run_id>/theta_arima.parquet (serie_id, theta, eps_ultimo, alpha_equivalente = 1+theta) — não faz parte do schema D (que não tem campo para hiperparâmetro por série), mas é o que sustenta a leitura "o α estimado por série diverge do α=0,5 fixo do pipeline" pedida no relatório; mantém rastreabilidade sem violar o schema exigido de D.
Modo fatia (--fatia/--fundir, adicionado na virada do canônico para min2, 01/09/2026): a base min2 (~7,37 M séries elegíveis, ~53% mais que o min4) não cabe numa chamada só do ambiente onde este módulo passou a rodar depois da virada — shell de 3,9 GB sem swap, cada chamada morre em ~180s, processo em background não sobrevive entre chamadas (min4 levou 223s inteiro, com folga de 19 GB de RAM na máquina do autor; aqui não há nem a RAM nem os 180s). A base é fatiada por (representação, ano_alvo) — 10 fatias fixas, cruzando as 2 representações de C com os 5 anos de protocolo.anos_alvo_backtest (config.yaml); não é um parâmetro novo em config.yaml porque não é uma decisão de modelagem — é só o jeito de caber o processamento em várias chamadas, refazer a granularidade não muda nenhum número. --fatia i lê só essa fatia de C via DuckDB (carregar_c_fatia, não pd.read_parquet(CAMINHO_C) — C tem 37,9 M linhas com serie_id string, carregar inteiro não cabe nos 3,9 GB), roda construir_matriz/ajustar_em_blocos só sobre ela, e grava um parcial em runs/<run_id>/_arima_fatias/ (fora do padrão predicoes*.parquet do run — não pode ser lido por engano por m50/m60 antes da fusão). --fundir concatena os 10 parciais nos arquivos finais (predicoes_arima.parquet, theta_arima.parquet), soma os tempos reais medidos por fatia (não extrapola) e escreve o relatório e o registry — mesmo formato que executar() (base inteira, uma chamada só) sempre escreveu, então quem lê o relatório não vê diferença entre os dois modos. executar() continua existindo sem mudança — é o caminho certo numa máquina com RAM/tempo de sobra (ex.: a do autor); o modo fatia é aditivo.
Fonte: pipeline/m40b_arima.py, docstring de módulo (extraída no build, sem Sphinx).
m50_avaliacao.py — Módulo 50 — Avaliação (guia §3.5/§7, plano Fase 3)
Entrada: runs/<run_id>/predicoes*.parquet (D) — todos os arquivos que casam esse padrão no diretório do run são lidos e concatenados (_carregar_predicoes), não só predicoes.parquet. Isso existe para o ARIMA (item 2 da auditoria, pipeline/m40b_arima.py): ele grava predicoes_arima.parquet à parte, com o mesmo schema D, em vez de reabrir e reescrever o predicoes.parquet grande — concatenar aqui é o que faz o ARIMA entrar nas métricas e comparações sem duplicar o arquivo publicado. Qualquer relatório que citar métricas do método "arima" deve deixar claro que o n dele é amostral (bem menor que os métodos P0, que rodam sobre a base inteira) — ver docstring de m40b_arima.py.
Saída: runs/<run_id>/metricas_agregadas.csv (arquivo E) — sempre derivado de D por este script, nunca calculado ad hoc em notebook. MAE + WAPE + bias médio/direção, sempre por etapa e por posição (nunca só global). segmento distingue duas leituras (guia §4/risco "cobertura nivelada"):
- sem_fallback: só séries com histórico suficiente (fallback_usado=False) — comparação justa entre os 5 métodos P0. É o segmento usado para qualquer alegação comparativa.
- com_fallback: todas as séries, incluindo as que só têm "último valor" por fallback — leitura operacional "predição para tudo".
Decomposição MAE = tamanho_médio × WAPE (guia §7) incluída no relatório, já que tamanho_médio = mean(y_true) e WAPE = sum(erro_abs)/sum(y_true) implicam tamanho_médio × WAPE = mean(erro_abs) = MAE exatamente, quando os dois usam o mesmo n.
Proibições do guia §7: MAPE em agregações, R² fora das comparações principais, "significativo" sem teste formal (isso é módulo 60), ranking global sem segmentação — por isso este relatório nunca reporta um único "campeão" sem qualificar por etapa/posição/segmento.
Fonte: pipeline/m50_avaliacao.py, docstring de módulo (extraída no build, sem Sphinx).
m60_estatistica.py — Módulo 60 — Estatística (guia §3.6/§7, plano Fase 5, experimento E6)
Entrada: runs/<run_id>/predicoes.parquet (D).
Saída: runs/<run_id>/testes_estatisticos.csv (+ .json) — protocolo unificado:
- método × método (Wilcoxon pareado + rank-biserial), dentro de cada representação, nas mesmas unidades (co_entidade, etapa_alvo, ano_alvo).
- retroativa × escalonada (Wilcoxon pareado + rank-biserial), por método, no subconjunto comum — formaliza estatisticamente o achado descritivo de E2/E4 (Fase 4).
- interna × fronteira (Mann-Whitney + rank-biserial, grupos independentes), por método, dentro da retroativa.
Holm aplicado separadamente dentro de cada família de testes (não globalmente — famílias testam hipóteses diferentes, corrigi-las juntas seria conservador demais sem necessidade).
Nota sobre N grande: com milhões de pares, quase qualquer diferença é "estatisticamente significativa" (p ≈ 0) — o número que importa aqui é o tamanho de efeito (rank-biserial), não o p-valor isolado (guia §7: proíbe "significativo" sem qualificar; CONTEXTO.md §15.2 Prof. Gustavo pede tamanho de efeito ao lado do teste formal).
Critério de sucesso (guia §8, E6): zero teste estatístico "solto" fora deste módulo.
ARIMA (item 2 da auditoria, pipeline/m40b_arima.py — Fase 1.3a/1.4 do plano de fechamento, 02/09/2026): d/d_reduzido concatenam todos os predicoes*.parquet do run — inclui predicoes_arima.parquet quando existe.
Histórico: até 01/09/2026 o ARIMA rodava amostral e testar_metodo_x_metodo ficava restrito a METODOS_P0 de propósito (um dropna() sobre o pivô inteiro encolheria a comparação dos 5 P0 para o tamanho da amostra do ARIMA). Isso mudou nos dois lados ao mesmo tempo: o ARIMA passou a rodar sobre a base elegível INTEIRA (sem amostragem — pipeline/m40b_arima.py), e testar_metodo_x_metodo passou a incluir todos os métodos (5 P0 + ensemble_media/mediana + arima) com dropna POR PAR em vez de um dropna global — ver docstring da função para o porquê (um dropna global ainda encolheria os pares P0 x P0 pela cobertura menor do ARIMA, que exige n_hist>=3; por par, cada comparação usa só a interseção dos dois métodos dela). testar_representacao_x_representacao e testar_interna_x_fronteira nunca filtraram por método — o ARIMA já entrava neles automaticamente antes dessa mudança, só que amostral; agora entra na base inteira, mesmo N que os outros métodos na mesma unidade.
Fonte: pipeline/m60_estatistica.py, docstring de módulo (extraída no build, sem Sphinx).
m70_relatorios.py — Módulo 70 — Relatórios (guia §3.7/§9, plano Fase 6)
Entrada: runs/<run_id_e1>/ completo (D, E, testes_estatisticos) + runs/<run_id_e5>/caracterizacao/ (módulo 20) + data/mapa_transicoes_etapas.csv.
Saída:
- Tabelas LaTeX T1-T6+T8 em runs/<run_id_e1>/tabelas/*.tex e figuras PNG F1,F2,F3,F5,F6 em runs/<run_id_e1>/figuras/*.png (guia §9).
- **T7 (GPR/coorte) e F4 (razões de progressão) ficam pendentes** — E7 não foi implementado nesta fase (guia §8 permite adiar: "se não couber, fica Maceió + trabalho futuro"; GPR é um tipo de modelo novo, não reaproveita os 5 P0). Rastreado como trabalho futuro.
- Relatório MD automático em runs/<run_id_e1>/relatorio_modulo70.md.
- Subcomando
export-site: dado um run_id, atualiza a figura Plotly em content/_data/<slug>/ (dado derivado, seguro de sobrescrever) e deixa um rascunho de texto em content/_rascunhos/, que o build.py ignora. Nunca escreve em caminho publicado: o texto final da página é revisado pelo autor — o exportador entrega dados + estrutura, não prosa. Substitui os scripts manuais tools/gen_fig_*.py usados nas Fases 1-5.
E9 (guia §8, "D + resíduos"): curva falta×sobra por quantil de compra, calculada aqui a partir dos resíduos do método "último valor" (retroativa, segmento sem_fallback) — leitura retrospectiva do trade-off de compra do PNLD, não uma nova predição (por isso não há risco de vazamento temporal: os quantis resumem erros já realizados no backtest, não alimentam nenhuma predição nova).
Carga de d (predicoes.parquet): executar() decide entre pd.read_parquet direto (runs pequenos, ex. fixtures de teste) e _carregar_d_reduzido (DuckDB, runs grandes) por tamanho de arquivo — ver _LIMIAR_DUCKDB_BYTES e a docstring de _carregar_d_reduzido para o motivo e o que exatamente é lido.
Fonte: pipeline/m70_relatorios.py, docstring de módulo (extraída no build, sem Sphinx).
3. O protocolo: backtest, elegibilidade, métricas e testes
Backtest de origem móvel, gap T−2
Cinco anos-alvo (protocolo.anos_alvo_backtest: 2021 a 2025), cada um com sua
própria janela de treino expansiva, sempre restrita a ano_obs ≤ ano_alvo − gap_minimo.
O gap_minimo vale 2 não por convenção estatística, mas porque é a defasagem real entre
o dado do Censo Escolar que fica disponível e o ano em que o PNLD decide a compra: testar com dado
que só existiria depois da decisão real não é backtesting válido para este problema, é um
vazamento disfarçado de generalização. O guia de
execução §6 tem o diagrama completo dos cinco folds; aqui vale o resumo: nenhum ano dentro do
gap entra em nenhum ajuste — nem o α da suavização exponencial, nem as iterações do EM do Kalman.
- Elegibilidade mínima
elegibilidade.min_anos_treino = 2— decisão do autor de 01/09/2026: "a elegibilidade mínima passa a ser o mínimo possível". Sensibilidade em 3, 4 e 5 anos (sensibilidade_min_anos).- Zeros
- Ausência de oferta da etapa, não quantidade zero de alunos — descartados do
histórico antes de contar
n_hist. - Rede
escopo.rede = [1, 2, 3]— federal, estadual, municipal. Escolas privadas nunca entram: fora do escopo do PNLD.
Duas métricas, nunca uma sem a outra
Toda predição gera um erro ŷ − y; as agregações abaixo
(pipeline/m50_avaliacao.py) partem dele.
| Métrica | Fórmula | Por quê |
|---|---|---|
| MAE | mean(|ŷᵢ − yᵢ|) |
Erro na escala real — alunos, o que decide quantos livros pedir. Sozinho, favorece etapas com escolas grandes. |
| WAPE | Σ|ŷᵢ − yᵢ| / Σyᵢ |
Erro como fração do volume — a única base válida para comparar etapas de porte muito diferente, como o 1º EF (turmas pequenas) e o Ensino Médio. |
As duas nunca aparecem sozinhas: MAE = tamanho médio × WAPE é uma identidade exata quando os
dois lados usam o mesmo n (pipeline/m50_avaliacao.py, docstring do módulo) —
o que torna a decomposição uma tabela obrigatória nas transições, separando quanto do erro é porte
da escola e quanto é penalidade proporcional real.
Os testes: por que dois, e por que Holm
| Teste | Quando | Efeito | Por quê |
|---|---|---|---|
| Wilcoxon pareado | método × método; retroativa × escalonada — mesma unidade (escola, etapa-alvo, ano-alvo) nos dois lados | r = (W₊ − W₋) / (W₊ + W₋) |
Compara duas medições da mesma unidade sem supor distribuição normal do erro, sem descartar o pareamento que um teste para grupos independentes jogaria fora. |
| Mann-Whitney | interna × fronteira — grupos independentes (uma etapa é uma coisa ou outra, nunca as duas) | r = 1 − 2U / (n₁·n₂) |
Mesma lógica não paramétrica, para quando não há pareamento possível: os dois grupos comparam etapas diferentes, não a mesma unidade sob duas condições. |
As duas fórmulas de efeito acima devolvem rank-biserial, na mesma escala: < 0,1 desprezível 0,1–0,3 pequeno 0,3–0,5 médio ≥ 0,5 grande — a régua usada em todo o Capítulo 5 (ver, por exemplo, os números do run canônico).
As comparações somam de centenas de milhares a milhões de pares. Com N nessa escala, o p-valor
converge para < 0,001 em quase qualquer comparação — inclusive diferenças sem
nenhuma relevância prática. É uma propriedade do tamanho da amostra, não do método: a partir de
certo N, um p pequeno deixa de discriminar "existe efeito" de "existe dado". O número que carrega
informação é o tamanho de efeito (rank-biserial) da tabela acima — por isso ele acompanha todo
teste do pipeline (pipeline/m60_estatistica.py, coluna
efeito_rank_biserial), nunca o p sozinho.
Por que correção de Holm, e por que não uma correção global
Cada família de teste (método × método; retroativa × escalonada; interna × fronteira) roda
vários testes ao mesmo tempo — método × método, por exemplo, compara C(7,2) = 21 pares de métodos
de uma vez. Sem correção, a chance de achar um "efeito" por puro acaso de múltiplas comparações
cresce com o número de testes. A correção de Holm (step-down) controla isso teste a teste, sem a
perda de poder de uma correção mais conservadora aplicada ao mesmo N.
pipeline/m60_estatistica.py aplica Holm separadamente dentro de cada
família, não globalmente — famílias testam hipóteses diferentes; corrigi-las juntas seria
conservador demais, sem necessidade metodológica.
4. Controlar por etapa: por que um segmento pode parecer pior sem ser
Comparar escolas estaduais com municipais, ou o Centro-Oeste com o Nordeste, pelo MAE agregado dá uma resposta — mas essa resposta pode estar medindo a coisa errada. A razão é mecânica: a etapa-alvo é, disparadamente, a variável que mais move o erro neste trabalho (o Ensino Médio erra dezenas de alunos a mais que o Fundamental, só por causa do tamanho médio das turmas), e os níveis de um segmento quase nunca têm a mesma mistura de etapas. Uma rede que concentra Ensino Médio vai parecer pior que uma rede que não tem Ensino Médio nenhum — mesmo que, etapa a etapa, as duas se comportem exatamente igual.
É o que acontece com rede, no run canônico (min2): 43,1% dos pares avaliáveis da rede estadual caem no Ensino Médio (1ª a 3ª série), contra apenas 0,1% na rede municipal — no universo de pares de todas as redes juntas, o Ensino Médio é só ~11,8%. A rede estadual está, por construção do próprio sistema educacional brasileiro (não do pipeline), sobre-representada exatamente nas etapas onde qualquer escola erra mais com a representação escalonada. Comparar o MAE agregado de estadual contra municipal sem isso em mente é comparar duas populações de etapas diferentes e chamar a diferença de "efeito de rede".
O que significa "controlar por etapa"
Controlar por etapa significa comparar dentro do mesmo terreno: medir a diferença entre representações separadamente em cada uma das doze etapas — só assim a composição deixa de interferir, porque dentro de uma etapa todas as escolas comparadas estão na mesma etapa. O problema é como depois juntar essas doze medidas numa única leitura por segmento. A tentação óbvia — juntar usando o peso que cada etapa tem dentro do próprio nível sendo medido — não funciona: como esse peso é exatamente a composição que se quer neutralizar, a soma ponderada por ele devolve, por definição, o mesmo número agregado bruto de onde se partiu. Controlar por etapa exige um peso compartilhado: a mesma participação de cada etapa, não importa qual nível do segmento está sendo somado — assim, um nível concentrado numa etapa deixa de "puxar" o resultado para o que aquela etapa favorece, e todos os níveis são comparados como se tivessem a mesma mistura de etapas.
A página qualificação × pipeline já fazia esta pergunta, mas controlando restringindo tudo a uma única etapa — o EF 5º ano, por ser a etapa com mais pares disponíveis (2,44 milhões, à frente de qualquer outra). Duas fraquezas: a escolha é arbitrária (nada além do tamanho da amostra justifica o 5º ano e não o 4º ou o 9º), e ela descarta a maior parte do subconjunto pareado de uma vez. Pior: o 5º ano não é neutro — é justamente uma etapa em que a escalonada tende a ganhar da retroativa: nas cinco regiões do país, sem exceção, o Δ MAE restrito só ao 5º ano é negativo (a escalonada com erro menor), mesmo nas regiões cujo Δ agregado bruto é claramente positivo (ver tabela abaixo). Controlar restringindo a essa etapa não é só perder poder estatístico: pode inverter o sinal do que se conclui, porque a etapa escolhida carrega seu próprio viés, não uma leitura neutra. O exemplo abaixo mostra isso acontecendo de fato.
| Etapa | Pares | Δ MAE (rede estadual) |
|---|---|---|
| EF 3º ano | 19.404 | +6,29 |
| EF 4º ano | 245.432 | −2,87 |
| EF 5º ano | 297.955 | −3,18 |
| EF 6º ano | 227.807 | +3,75 |
| EF 7º ano | 238.481 | +4,30 |
| EF 8º ano | 253.242 | −0,86 |
| EF 9º ano | 600.330 | −3,18 |
| EM 1ª série | 464.731 | +13,86 |
| EM 2ª série | 474.716 | +11,78 |
| EM 3ª série | 486.122 | +8,99 |
Δ MAE = MAE(escalonada) − MAE(retroativa), pareado, rede estadual, todas as etapas
com pelo menos 30 pares. Positivo favorece a retroativa. Run Cálculo: comparação pareada retroativa × escalonada (mesma escola, etapa-alvo, ano-alvo, método; sem fallback; y_true não-nulo — protocolo de Fonte: e1-20260804-175333pipeline/m50_avaliacao.py::comparar_representacoes), agrupando os 8 métodos disponíveis no run (5 P0 + 2 ensembles + ARIMA, este último com cobertura menor por já entrar filtrado por sucesso), restrita a escolas da rede estadual, uma linha por etapa-alvo.tools/analise_controle_etapa.py → runs/e1-20260804-175333/analise_controle_etapa/por_estrato.csv
O sinal muda seis vezes ao longo da cadeia. Restringir tudo ao EF 5º ano isolado dá Δ = −3,18 — a escalonada parecendo francamente melhor na rede estadual. Olhar o MAE agregado bruto (que mistura a composição) dá o oposto: Δ = +4,42, a retroativa francamente melhor. Nenhuma das duas leituras usa a informação inteira. A leitura que soma as dez etapas com o mesmo peso que elas têm no total de pares de todas as redes — não o peso que têm dentro da rede estadual — dá Δ = +1,06: ainda a favor da retroativa, mas um quarto do valor bruto. A diferença entre +4,42 e +1,06 é o tanto do "efeito de rede estadual" que era, na verdade, a rede estadual carregando mais Ensino Médio que a média do país.
Como ler a figura
Run Cálculo: para cada segmento (rede, região, localização, porte em tercis) e nível, Δ bruto é o MAE pareado agregado sobre as dez etapas com cobertura escalonada; Δ agrupado estima o Δ dentro de cada etapa separadamente (mínimo de 30 pares por célula) e soma essas dez estimativas com o peso que cada etapa tem no universo do próprio tipo de segmento — o mesmo peso para todo nível daquele segmento, não o peso que a etapa tem dentro do nível sendo medido. Protocolo pareado idêntico ao de Fonte: e1-20260804-175333pipeline/m50_avaliacao.py::comparar_representacoes; efeito e teste de pipeline/m60_estatistica.py::_wilcoxon_pareado, reaproveitados sem reimplementação. 12.170.352 pares, 8 métodos (inclui ARIMA, cobertura menor).tools/analise_controle_etapa.py → runs/e1-20260804-175333/analise_controle_etapa/resumo.csv
| Segmento | Nível | Δ bruto | Efeito (bruto) | Δ agrupado | Efeito (agrupado) | Δ EF 5º ano isolado |
|---|---|---|---|---|---|---|
| Porte | Pequeno | −0,30 | +0,236 · pequeno | −0,36 | +0,237 · pequeno | −0,51 |
| Porte | Médio | −0,30 | +0,164 · pequeno | −0,30 | +0,157 · pequeno | −0,96 |
| Localização | Rural | +0,03 | +0,140 · pequeno | +0,18 | +0,124 · pequeno | −0,80 |
| Rede | Municipal | +0,45 | +0,094 · desprezível | +1,43 | +0,046 · desprezível | −1,58 |
| Região | Nordeste | +1,17 | +0,055 · desprezível | +2,16 | +0,032 · desprezível | −1,01 |
| Região | Norte | +1,17 | +0,049 · desprezível | +1,74 | +0,040 · desprezível | −1,19 |
| Região | Sudeste | +1,30 | +0,067 · desprezível | +0,63 | +0,115 · pequeno | −3,49 |
| Região | Sul | +2,00 | +0,025 · desprezível | +1,39 | +0,076 · desprezível | −1,75 |
| Porte | Grande | +2,74 | −0,017 · desprezível | +2,16 | +0,025 · desprezível | −2,71 |
| Localização | Urbana | +2,75 | −0,011 · desprezível | +2,13 | +0,031 · desprezível | −2,71 |
| Região | Centro-Oeste | +4,33 | −0,088 · desprezível | +3,50 | −0,051 · desprezível | −0,87 |
| Rede | Estadual | +4,42 | −0,071 · desprezível | +1,06 | +0,096 · desprezível | −3,18 |
| Rede | Federal | +4,77 | −0,210 · pequeno | +4,66 | −0,214 · pequeno | +0,48 |
Δ MAE em alunos, positivo favorece a retroativa. Efeito = rank-biserial (Wilcoxon pareado): <0,1 desprezível · 0,1–0,3 pequeno · 0,3–0,5 médio · ≥0,5 grande. A coluna "Δ EF 5º ano isolado" reproduz o método anterior (uma única etapa) para comparação direta — não entra no agrupamento.
Rede, região e localização continuam sem sustentar um efeito de magnitude grande depois de controlados: todo Δ agrupado corresponde a um efeito rank-biserial desprezível ou pequeno, nunca médio ou grande — a mesma conclusão qualitativa da página de qualificação × pipeline. O que muda é o caminho até lá: a coluna "Δ EF 5º ano isolado" tem sinal oposto ao Δ agrupado em 10 dos 13 níveis testados — olhar só essa etapa não apenas perde poder, leva à conclusão contrária na maioria dos casos. Dois segmentos não se movem quase nada entre bruto e agrupado — porte (o mesmo achado já registrado na página de qualificação × pipeline) e rede federal, que concentra Ensino Médio quase tanto quanto a estadual (40,6% dos seus pares, contra 43,1% da estadual) mas não encolhe quando essa composição é neutralizada — evidência de que o efeito de federal não é a composição de etapas que ele carrega.
5. O roteador — ensemble a priori
Os cinco métodos e os dois ensembles do Capítulo 5 respondem a uma pergunta descritiva: "qual combinador funciona melhor, dado um pool fixo?" O roteador responde a uma pergunta diferente, operacional: para esta escola, nesta etapa-alvo, neste ano, qual representação — retroativa ou escalonada — e qual método usar, antes de gerar a predição, não depois de combinar várias. É por isso que ele é chamado de ensemble a priori: a escolha é condicionada à taxonomia da série (posição, etapa-alvo e, quando paga, volatilidade histórica e porte), estimada só em 2021-2023 e aplicada fora da amostra em 2024-2025 — nunca vê o ano que avalia.
As 8 predições por unidade (5 P0 + 2 ensembles + ARIMA) já existiam em
predicoes*.parquet antes do roteador existir — ele só decide qual delas usar. Código:
tools/analise_roteador.py; relatório completo:
runs/e1-20260804-175333/relatorio_roteador.md.
A cascata de retaguarda
A escalonada não é elegível em toda etapa (o EF 1º ano, por construção — seção 1 acima), e o
ARIMA exige n_hist≥3, contra n_hist≥2 dos outros 6 métodos do pool
P0+ensembles. O roteador cobre isso com uma cascata em quatro degraus, não uma escolha única sem
plano B: tenta o braço de menor erro de treino no estrato; se ele não existir nesta unidade
específica, cai para o próximo melhor método na mesma representação; se a própria representação não
existir para esta série, troca de representação; e, no limite, cai para ultimo_valor —
o único método com cobertura a partir de n_hist≥1, por isso o único que quase sempre
existe.
Como ler. cada degrau é tentado nesta ordem; a seta "indisponível para
esta unidade" é o que dispara o próximo. A pílula colorida é a fração das 1.170.156 unidades de
teste (2024-2025, qualquer representação) que parou naquele degrau — 100% coberto,
72,7% já no degrau 1. Run Cálculo: a regra treinada em 2021-2023 (posição × etapa-alvo × quartil de CV histórico × tercil de porte defasado) aplicada unidade a unidade em 2024-2025, com a cascata de 4 degraus descrita no texto — Fonte: e1-20260804-175333 · gerado em 2026-09-02tools/analise_roteador.py::aplicar_cascata. Universo: toda unidade (escola, etapa-alvo, ano-alvo) com y_true observado, qualquer representação — não o universo restrito da comparação da seção seguinte.tools/analise_roteador.py → runs/e1-20260804-175333/analise_roteador/cascata_cobertura.csv
A regra, como tabela
No estrato base (posição × etapa-alvo, antes do refinamento por CV/porte), a escolha primária
(degrau 1) e o primeiro fallback (degrau 2) são estas — a leitura direta é que o ARIMA
entra como primeira escolha em 4 das 12 etapas (sempre na escalonada, sempre onde
n_hist≥3 é comum o bastante para o treino confiar nele):
| Etapa | Posição | Degrau 1 — representação | Degrau 1 — método | MAE treino | Degrau 2 (mesma repr.) |
|---|---|---|---|---|---|
| EF 1º ano | fronteira | retroativa | suav_exp | 7,70 | ensemble_media |
| EF 2º ano | interna | retroativa | suav_exp | 7,66 | ensemble_media |
| EF 3º ano | interna | escalonada | kalman | 4,42 | ensemble_mediana |
| EF 4º ano | interna | escalonada | arima | 4,62 | kalman |
| EF 5º ano | interna | escalonada | ensemble_mediana | 5,62 | kalman |
| EF 6º ano | fronteira | escalonada | arima | 12,77 | ensemble_media |
| EF 7º ano | interna | escalonada | arima | 12,24 | ensemble_media |
| EF 8º ano | interna | escalonada | ensemble_mediana | 7,75 | kalman |
| EM 1ª série | fronteira | retroativa | ensemble_mediana | 30,64 | ensemble_media |
| EM 2ª série | interna | retroativa | suav_exp | 29,31 | ensemble_media |
| EM 3ª série | interna | escalonada | suav_exp | 23,75 | ensemble_media |
| EF 9º ano | interna | escalonada | arima | 9,57 | kalman |
Run Cálculo: MAE de treino (2021-2023) de cada braço (representação, método), por estrato — Fonte: reglin e media nunca aparecem como degrau 1 — consistente
com A_geral do relatório e8 (reglin é sempre o pior isolado). A versão em produção
(V2) refina cada uma destas 12 linhas por quartil de CV histórico e tercil de porte — 150
subestratos, ilegível em prosa; a tabela fina completa está em
runs/e1-20260804-175333/analise_roteador/regra_V2_mais_porte.csv.e1-20260804-175333 · gerado em 2026-09-02tools/analise_roteador.py::treinar_arm_mae + montar_decisao. Braço só entra na regra com n_treino≥200.tools/analise_roteador.py → runs/e1-20260804-175333/analise_roteador/regra_V0_posicao_etapa.csv
As features que pagaram
Testadas incrementalmente sobre o mesmo universo comparável e os mesmos anos de teste — a disciplina do pedido ("comece simples e só acrescente feature que pague"). Números corrigidos em 04/09 — a versão publicada em 02/09 tinha vazamento no CV histórico; ver o alerta logo abaixo antes de citar qualquer MAE desta seção:
| Versão | Features além de posição × etapa | MAE teste | Ganho |
|---|---|---|---|
| V0 | nenhuma | 10,35 | — |
| V1 produção | + quartil de CV histórico | 10,08 | +0,27 |
| V2 | + tercil de porte (defasado 2 anos) | 10,15 | +0,20 total |
CV histórico paga. Porte, na leitura corrigida, deixa de pagar em cima do CV para
este split — 10,15 contra 10,08, pior, não melhor — por isso a marca de produção
passa de V2 para V1. A diferença entre as duas (0,07 aluno) é pequena diante da dispersão do
roteador entre folds (desvio-padrão 1,57, seção "origem móvel" abaixo): não é evidência forte de que
porte não ajude em geral, só de que não paga de forma confiável neste split específico — o vazamento
estava no CV, não no porte (o porte já juntava pelo censo de Run Cálculo: MAE do roteador no universo comparável (retroativa, 7 métodos P0+ensembles presentes, Fonte: ano_alvo − 2, o gap do
protocolo, desde a primeira versão; nenhuma mudança nele). A marca de série com buraco ficou de fora
por decisão de desenho: ao contrário de CV/porte, ela é calculada separadamente para cada
representação — usá-la para ESCOLHER a representação seria circular.e1-20260804-175333 · números corrigidos em 2026-09-04 (a versão de 02/09 tinha vazamento — ver alerta abaixo)n_hist≥2), teste 2024-2025, n=1.147.959, para cada conjunto de features, com cv_hist/cv_quartil recalculado só até 2021 (fim da janela de treino − gap_minimo), nunca tocando 2022 em diante — tools/analise_roteador.py::executar_fold (--modo cv --cv-etapa controle --cv-controle-variante seguro).tools/analise_roteador.py → runs/e1-20260804-175333/analise_roteador/cv/controle_vazamento_seguro_mesmo_split/ganho_por_feature.csv
O Run Cálculo: mesmo split (treino 2021-2023, teste 2024-2025) rodado duas vezes, tudo idêntico exceto a origem do CV — Fonte: cv_hist usado como feature acima era calculado sobre TODO o histórico de
observacoes.parquet, 2007–2025 — incluindo os próprios anos de teste, 2024 e
2025, no denominador do desvio-padrão. Na prática, a estatística usada para decidir qual
método aplicar a uma escola em 2024/2025 já continha a matrícula real daquele mesmo ano — vazamento
do y para dentro do insumo de decisão. O erro foi encontrado ao rodar a validação de origem
móvel pedida para checar se o ganho se sustenta fora de um único corte (nenhuma rodada de modelo
nova — é reavaliação sobre as predições que já existiam). Corrigido — CV recalculado só até o fim de
cada janela de treino, nunca tocando o ano sendo testado —, o MESMO split publicado (treino
2021-2023, teste 2024-2025) dá 10,08, não 9,89. A conclusão qualitativa não muda: o
roteador segue à frente dos 5 concorrentes (seção seguinte) e dos 4 folds da validação cruzada (mais
abaixo) — mas o número publicado primeiro estava inflado, e é o corrigido que deve ser citado daqui
em diante.e1-20260804-175333 · checagem gerada em 2026-09-04cv_hist do corte global 2007-2025 (vazado_original, reproduz o roteador publicado em 02/09) vs. cv_hist recalculado só até 2021 (seguro_mesmo_split) — tools/analise_roteador.py::executar_controle_vazamento. Os 5 concorrentes e os 2 oráculos ficam idênticos (bit-a-bit) entre as duas variantes, porque nenhum deles usa cv_hist — só o roteador muda.tools/analise_roteador.py → runs/e1-20260804-175333/analise_roteador/cv/controle_vazamento_delta.csv e relatorio_roteador_cv.md
Contra os concorrentes
No mesmo universo comparável (retroativa, os 7 métodos do pool presentes, n=1.147.959, 2024-2025) — os 5 concorrentes usam sempre a retroativa (a leitura padrão sem roteador: cobertura quase universal e já comprovadamente melhor que "preferir escalonada quando existir", relatório e8, B3); o roteador é livre para escolher a escalonada quando o treino disser que compensa:
| Combinador | MAE |
|---|---|
| roteador (V1) | 10,08 |
| oráculo geral (teto do espaço de ação do roteador) | 3,87 |
| melhor método isolado (suav_exp, sem estratificar) | 10,40 |
| seletor por estrato (o que já existe) | 10,43 |
| ensemble média | 10,43 |
| ensemble mediana | 10,49 |
| último valor | 11,28 |
O roteador ganha dos 5 — inclusive do seletor por estrato, o melhor combinador do
Capítulo 5 (10,45 no run original; 10,43 nesta leitura retroativa-apenas comparável). Efeito pequeno
mas robusto: Wilcoxon pareado + rank-biserial + Holm (protocolo de
Run Cálculo: universo comparável = retroativa, os 7 métodos de Fonte: pipeline/m60_estatistica.py), rank-biserial entre −0,13 e −0,21 nas 5 comparações
(escala: <0,1 desprezível · 0,1–0,3 pequeno · 0,3–0,5 médio · ≥0,5 grande), p<0,001 em
todas depois de Holm, n pareado entre 799 mil e 1,13 milhão. "Ganha, pouco" é a leitura
honesta — não um salto qualitativo. Com o número corrigido, o roteador fecha 5,3% do gap até o teto
do seu próprio espaço de ação (seletor → oráculo geral) e 16,2% partindo do último valor (eram 8,2%
e 18,8% na leitura vazada — o vazamento também inflava a fração do gap fechado, não só o MAE). Não é
o mesmo gap de 4,05 do relatório e8 — aquele foi medido com as duas representações como observações
separadas, este é o teto de um espaço de ação maior (inclui a escalonada e o ARIMA). Estes números
valem para ESTE split; a validação de origem móvel logo abaixo mostra que a margem varia por
ano.e1-20260804-175333 · números corrigidos em 2026-09-04 (a publicação de 02/09 usava CV vazado — ver alerta na seção anterior)pipeline.universos.CAMADA_P0_ENSEMBLES presentes (n_hist≥2) — pipeline/universos.py::camada_para_comparacao. Teste pareado nas mesmas unidades dos dois lados; cv_hist do roteador cortado em 2021 (fim do treino − gap_minimo), nunca vê 2024/2025.tools/analise_roteador.py → runs/e1-20260804-175333/analise_roteador/cv/controle_vazamento_seguro_mesmo_split/comparacao_mae.csv e comparacao_teste_estatistico.csv
Em 4 dos 12 estratos (posição × etapa), o roteador (V1, versão corrigida) tem MAE pior que o
seletor por estrato — em 3 deles a diferença é pequena a moderada (0,01 a 1,37 aluno: EF 2º ano, EF
6º ano, EF 7º ano). O caso que pesa continua sendo a EM 3ª série: +6,18 alunos
contra o seletor (pior que os +5,16 da leitura anterior, com vazamento). Mesma explicação de antes:
nessa etapa, a estratificação por CV deixa alguns subestratos com Run Cálculo: MAE por estrato (posição × etapa-alvo) do roteador (versão V1, CV fold-segura) contra o seletor por estrato, mesmo split treino 2021-2023/teste 2024-2025 — Fonte: n_treino baixo — a
regra super-ajusta onde o treino é mais escasso. Para EM 3ª série especificamente, o seletor por
estrato simples é a escolha mais segura, não o roteador fino.e1-20260804-175333 · números corrigidos em 2026-09-04tools/analise_roteador.py::onde_perde.tools/analise_roteador.py → runs/e1-20260804-175333/analise_roteador/cv/controle_vazamento_seguro_mesmo_split/onde_perde_por_estrato.csv
O ganho é estável? Validação de origem móvel, 4 folds
Um único corte treino/teste não separa "ganho real" de "par de anos favorável" — o n de teste é grande, mas n grande não substitui mais de um fold. Origem móvel expansiva, sem gap (treino termina no ano imediatamente anterior ao teste, mesma convenção do corte único acima): treino 2021 → teste 2022; treino 2021-22 → teste 2023; treino 2021-23 → teste 2024; treino 2021-24 → teste 2025. CV histórico recalculado em cada fold, cortado no fim da própria janela de treino — nunca vê o ano de teste daquele fold (a mesma correção de cima, repetida fold a fold).
| Ano teste | Anos treino | Roteador | Melhor isolado | Seletor estrato | Último valor |
|---|---|---|---|---|---|
| 2022 | 2021 | 9,71 | 10,86 | 10,90 | 11,51 |
| 2023 | 2021-2022 | 13,07 | 13,32 | 13,39 | 14,98 |
| 2024 | 2021-2023 | 10,10 | 10,48 | 10,49 | 11,44 |
| 2025 | 2021-2024 | 10,03 | 10,32 | 10,36 | 11,12 |
O roteador vence os 5 concorrentes nos 4 folds, sempre com Holm
significativo — o ganho é direcional e robusto. Mas o tamanho do efeito não é: cai
de "pequeno" (2022, rank-biserial −0,23 contra o melhor isolado) para "desprezível" contra o melhor
isolado em 2023 (−0,10) e contra 4 dos 5 concorrentes em 2025 (−0,08 a −0,10) — nunca inverte de
sinal, mas se aproxima de zero. Dispersão do MAE do roteador entre os 4 folds: média 10,73,
desvio-padrão 1,57 (CV 14,7%), mínimo 9,71 (2022), máximo 13,07 (2023 —
pior fold). A leitura honesta é "ganha consistentemente, por pouco" — não
"ganha por uma margem confortável e estável". Run Cálculo: validação cruzada de origem móvel, 4 folds (treino expansivo, sem gap), CV histórico fold-seguro em cada fold (cortado em Fonte: e1-20260804-175333 · gerado em 2026-09-04max(anos_treino) − gap_minimo, nunca vê o ano de teste do próprio fold) — tools/analise_roteador.py --modo cv --cv-etapa fold. Protocolo estatístico de pipeline/m60_estatistica.py (Wilcoxon pareado + rank-biserial + Holm, dentro de cada fold).tools/analise_roteador.py → runs/e1-20260804-175333/analise_roteador/cv/resumo_cv_fold_a_fold.csv, dispersao_por_combinador.csv e relatorio_roteador_cv.md (relatório completo, fold a fold)
2023 é o pior fold — mas para os 8 combinadores testados igualmente (até o último valor isolado sobe de ~11,1-11,5 nos outros folds para 14,98 em 2023; o oráculo geral sobe de ~3,85-3,95 para 5,10). Contra a expectativa de que o fold com janela de treino mais curta fosse o pior, o fold de 2022 — treinado com só 1 ano de dados — teve o menor MAE do roteador e o maior efeito relativo sobre os concorrentes. Não há, nestes 4 folds, evidência de que a regra precise de mais de 1 ano de histórico de treino para funcionar: o que domina a variação entre folds parece ser o ano-alvo em si — 2023 difícil para todo mundo —, não a profundidade do treino. É uma leitura diferente de "precisa de mais histórico", e uma informação prática distinta para o PNLD: o risco a vigiar está em anos atípicos, não em regras jovens.
A margem até o oráculo por unidade (3,87 a 5,89, conforme a leitura) não é toda alcançável. A
concordância da escolha do oráculo entre anos consecutivos, para a mesma unidade, é fraca (kappa de
Cohen = 0,105, contra as marginais reais de cada ano — não contra 1/5), e o oráculo
defasado — a escolha que o oráculo faria no ano anterior, aplicada à predição do ano
corrente, a única forma realizável de perseguir o oráculo — tem MAE 11,29 no subconjunto
onde é aplicável (85,2% do universo de teste), pior que o próprio roteador no mesmo
subconjunto (10,99). O roteador que já existe hoje já bate a régua honesta baseada em persistência
ano a ano — não sobra margem alcançável por esse caminho: a distância até o oráculo perfeito é, em
boa parte, sorte de amostra única, não um padrão que uma regra causal (treinada só com o passado)
possa capturar. Detalhe completo em
Run Cálculo: kappa de Cohen (contra as marginais reais de cada ano, não 1/5) sobre a escolha do oráculo por unidade entre pares de anos consecutivos, pooled 4 pares (2021→2025); oráculo defasado = escolha do oráculo no ano anterior aplicada à predição do ano corrente, no subconjunto onde aplicável — Fonte: runs/e1-20260804-175333/relatorio_oraculo.md.e1-20260804-175333 · gerado em 2026-09-04, por outro agente, em paralelo à validação de origem móveltools/analise_oraculo.py.tools/analise_oraculo.py → runs/e1-20260804-175333/analise_oraculo/estabilidade_kappa.csv, defasado_resumo_mae.csv e relatorio_oraculo.md
6. Trabalhos futuros: os cortes definitivos
Toda exclusão de escopo neste trabalho tem uma frase de justificativa — convenção do guia de execução, mantida aqui para o que foi cortado em definitivo em 01/09/2026, para não reabrir depois do congelamento.
| Corte | Por quê |
|---|---|
| KMeans de regimes | Identificar regimes de estabilidade por clustering seria uma pergunta descritiva adicional, fora do eixo único do Caminho E (transições como explicação da heterogeneidade). A pergunta de "por que o último valor é difícil de superar" já tem resposta sem introduzir um método novo: E5 (estabilidade e persistência). |
| Métodos Fuzzy | Mudariam a família de modelos (os cinco P0 mais o ensemble) no meio do congelamento de experimentos, sem sinal de que resolveriam algo que a suavização exponencial e o ensemble por média já não resolvem. |
| GPR em escala nacional completa | O efeito medido é de ~5% num único município (Maceió) — não sustenta transformar o método numa proposta nacional. O E7 testa a mesma direção numa amostra estratificada; não vira produção nacional. |
| Quantificação de incerteza / conformal prediction | A pergunta de compra sob incerteza já tem resposta operacional pela curva falta×sobra por quantil empírico de resíduo (E9, ver run canônico). A garantia formal de cobertura do conformal fica como eixo à parte, não decidido para este trabalho. |
| PNLD × Censo | Não existe dado público de quanto o PNLD efetivamente comprou por escola — não há como cruzar decisão real de compra com o Censo. A curva de compra/risco (E9) já é a melhor aproximação possível sem esse dado. |
| Alocação espacial | Resultado negativo documentado: a formulação testada não resolveu as fronteiras. Reabre só numa versão futura recortada por rede de ensino — não como a formulação atual. |
| Cohort Survival como método próprio | Absorvido pelo E7 amostral: o plano de experimentos já tratava "Cohort-survival / GPR" como a mesma ideia — razões de progressão grade-a-grade. Manter os dois nomes separados no texto final duplicaria um método, não descreveria dois. |
Efeito Ceará: limitação declarada, não investigação nova
A diferença de MAE entre retroativa e escalonada no Ceará tem sinal oposto ao do resto do país e resiste a todos os controles testados (composição de etapas, porte, localização, rede) — ver qualificação × pipeline para os números completos. Nenhum mecanismo foi identificado. Por decisão do autor de 01/09/2026, o achado entra no texto final como limitação declarada, não como uma nova linha de investigação: o prazo de congelamento (15/09) não comporta abrir uma frente nova para explicar uma anomalia geográfica que os dados atuais não decidem.